
Phân tích đối lập: Dữ liệu hỗn loạn truyền thống và hệ sinh thái AI trong xây dựng Việt Nam

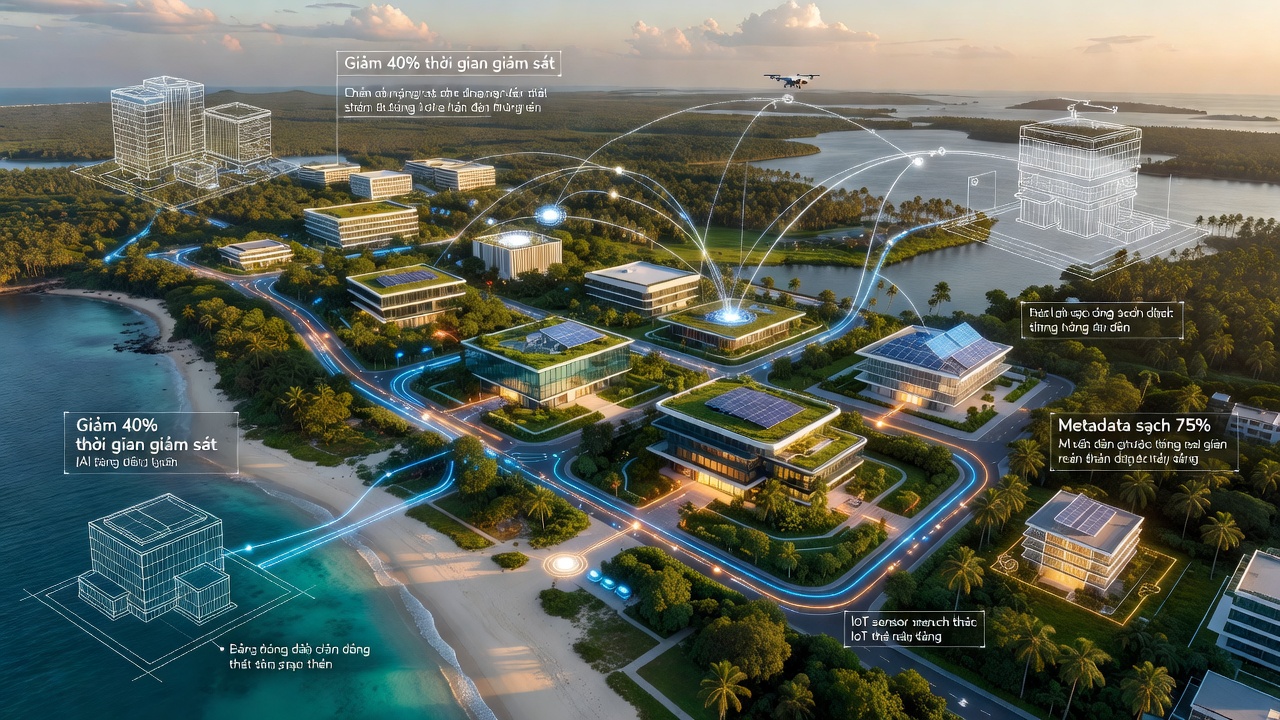
Phân tích đối lập: Khi dữ liệu hỗn loạn truyền thống va chạm với hệ sinh thái dữ liệu được AI tái cấu trúc trong ngành xây dựng Việt Nam
(Tình huống sau đây hoàn toàn là giả định, được dựng lên chỉ để minh họa cho mục đích phân tích kỹ thuật.)
Giả sử tại công trường tuyến Metro số 2 TP.HCM (giả định), vào tháng 6/2025, một kỹ sư giám sát phải đối mặt với hai phiên bản thực tế song song. Phiên bản thứ nhất: 17.000 bức ảnh drone, 2.400 file BIM, hàng nghìn biên bản nghiệm thu giấy và file Excel phân tán trên 9 nhà thầu phụ. Phiên bản thứ hai: một hệ thống AI đã được huấn luyện để xử lý toàn bộ đống hỗn loạn đó. Dưới đây là sự đối lập sắc nét giữa hai thế giới.
1. Thu thập và phân mảnh dữ liệu
Thế giới truyền thống thu thập dữ liệu như nhặt rác sau bão: ảnh chụp bằng điện thoại cá nhân, file .jpg đổi tên thủ công theo kiểu “anh_01_final_v2_real_final”, dữ liệu IoT từ máy bơm bê tông bị ngắt quãng vì SIM 4G yếu. Kết quả là metadata gần như không tồn tại, tiến độ thực tế bị chôn vùi trong 40–60% dữ liệu “mồ côi”.
Hệ sinh thái AI giả định yêu cầu pipeline thu thập có chủ đích: camera cố định kết hợp drone bay định kỳ đẩy ảnh qua API có timestamp và GPS nhúng sẵn. Tuy nhiên, chất lượng đầu vào quyết định tất cả. Nếu ảnh bị thiếu metadata EXIF hoặc drone bay sai góc (dưới 30° so với mặt đứng), mô hình computer vision sẽ tăng tỷ lệ false negative lên 25–35%. Chi phí annotation thủ công để tạo ground-truth cho 10.000 ảnh hiện trường có thể lên tới 180–250 triệu đồng chỉ cho một gói dữ liệu nhỏ.
2. Chuẩn hóa tài liệu và metadata
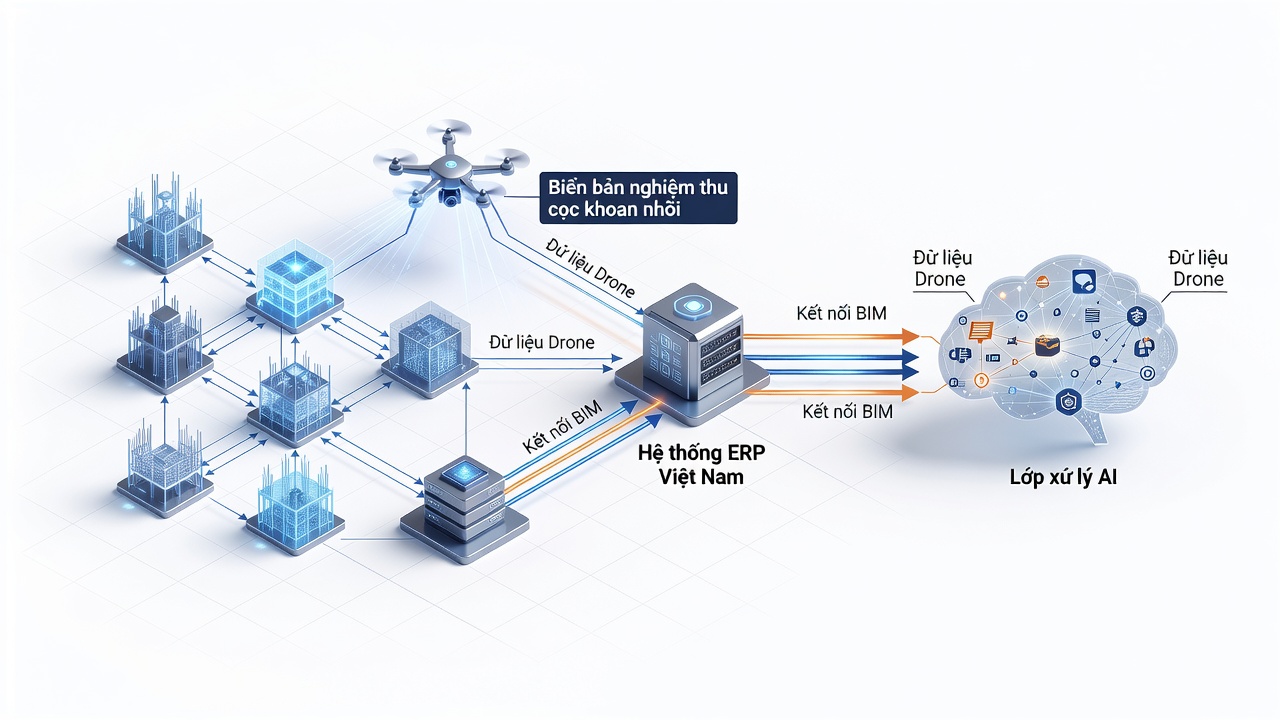
Excel và giấy tờ truyền thống không có schema cố định. Một biên bản nghiệm thu có thể mang tên “BBNT_KD_05”, “Biên bản 05”, hoặc “BB-05-rev3” tùy từng nhà thầu. Việc tìm kiếm gần như bất khả thi.
Ở phía AI, NLP được dùng để phân loại tự động theo TCVN 9381:2023 và TCVN 5574:2018. Mô hình transformer fine-tune trên corpus hợp đồng xây dựng Việt Nam có thể trích xuất các thực thể như “nghiệm thu bê tông cốt thép”, “sai lệch vị trí cọc”, “ngày nghiệm thu”. Độ chính xác F1 đạt khoảng 87–91% khi dữ liệu huấn luyện sạch; nhưng chỉ cần 15% tài liệu bị scan mờ hoặc dùng font không chuẩn là độ chính xác rơi xuống dưới 70%. Knowledge graph sau đó nối các thực thể này với Autodesk Construction IQ qua API, tạo node “Biên bản nghiệm thu cọc khoan nhồi – Trạm 12 – Nhà thầu phụ B – ERP nội địa”.
3. Xử lý dữ liệu phi cấu trúc từ BIM, Drone và IoT
Computer vision tại công trường Metro (giả định) sử dụng mô hình segmentation kết hợp object detection để đo tiến độ. Ảnh drone được chạy qua mô hình YOLOv8 fine-tune trên tập dữ liệu 8.000 ảnh công trình Việt Nam, phát hiện “cột bê tông đã đổ tầng 3” hay “ván khuôn đang tháo”. Kết quả so sánh với mô hình 4D BIM để tính phần trăm hoàn thành. Sai số điển hình nằm ở vùng che khuất và điều kiện ánh sáng mạnh – hai yếu tố rất phổ biến tại công trường miền Nam.
4. Rủi ro bảo mật và tuân thủ pháp lý Việt Nam
Dữ liệu truyền thống nằm rải rác trên USB và email cá nhân, dễ bị lộ nhưng cũng khó bị tấn công quy mô lớn. Hệ thống AI tập trung hóa dữ liệu vào một nền tảng duy nhất, tạo ra bề mặt tấn công lớn hơn. Theo Luật An ninh mạng và Nghị định 13/2023/NĐ-CP về bảo vệ dữ liệu cá nhân, mọi dữ liệu công trình hạ tầng quan trọng phải được xử lý trong lãnh thổ Việt Nam.
5. Đo lường ROI thực tế khi áp dụng AI
ROI không nằm ở slide PowerPoint “giảm 40% thời gian”. Thực tế (giả định) cho thấy: sau 8 tháng triển khai, chi phí annotation, fine-tune và kiểm tra chất lượng dữ liệu chiếm 62% tổng ngân sách AI. Giảm được 1,2 kỹ sư giám sát là con số thực, nhưng chi phí duy trì mô hình (re-training mỗi quý vì điều kiện công trường thay đổi) lại nuốt gần hết khoản tiết kiệm đó. ROI dương chỉ xuất hiện khi dữ liệu đầu vào đạt tỷ lệ metadata sạch trên 75% và annotation được thực hiện bởi đội ngũ am hiểu TCVN.
Bài học từ những sai lầm đối lập
Ranh giới giữa AI thực sự và công cụ tiếp thị nằm ở hai câu hỏi đơn giản: (1) Dữ liệu huấn luyện có được tạo ra từ chính công trường Việt Nam hay chỉ là dữ liệu tổng hợp nước ngoài? (2) Chi phí annotation và re-training có được tính vào tổng chi phí sở hữu (TCO) hay bị giấu dưới tiêu đề “triển khai một lần”?
Bất kỳ giải pháp nào không trả lời được hai câu hỏi trên, dù có dùng từ “AI” nhiều đến đâu, cũng chỉ là Excel được sơn màu mới.


