
Đảm bảo khả năng sao chép kết quả AI: Bài học từ hai startup fintech Việt Nam năm 2025

Mở đầu: Khi “chạy được một lần” trở thành rủi ro hệ thống
Năm 2025, thị trường fintech Việt Nam ghi nhận hơn 180 startup có pipeline AI đang vận hành, nhưng chỉ khoảng 27% duy trì được điểm số khả năng sao chép kết quả trên 0,85 theo chuẩn nội bộ do một số quỹ đầu tư mạo hiểm yêu cầu. Hai nhóm nghiên cứu tại hai công ty cùng quy mô (Series B, khoảng 120 nhân sự) đã đi hai hướng ngược nhau chỉ vì một quyết định: có bắt buộc sao chép độc lập kết quả hay không. Một bên tăng trưởng doanh thu sản phẩm chấm điểm tín dụng gấp 4,2 lần; bên kia buộc phải đóng cửa module AI sau khi kiểm toán phát hiện chênh lệch 31% giữa kết quả báo cáo và kết quả thực tế.
Yêu cầu sao chép độc lập kết quả
Nhóm thành công thiết lập quy trình “cổng kiểm soát khả năng sao chép hai người”: mọi yêu cầu hợp nhất mã nguồn vào nhánh chính đều phải được một kỹ sư không tham gia huấn luyện chạy lại trên môi trường mới trong vòng 48 giờ. Nhóm thất bại coi đây là thủ tục hành chính, cho phép hợp nhất chỉ cần “hàm mất mát giảm và độ chính xác trên tập phát triển ổn định”.
Container hóa với Docker và Kubernetes
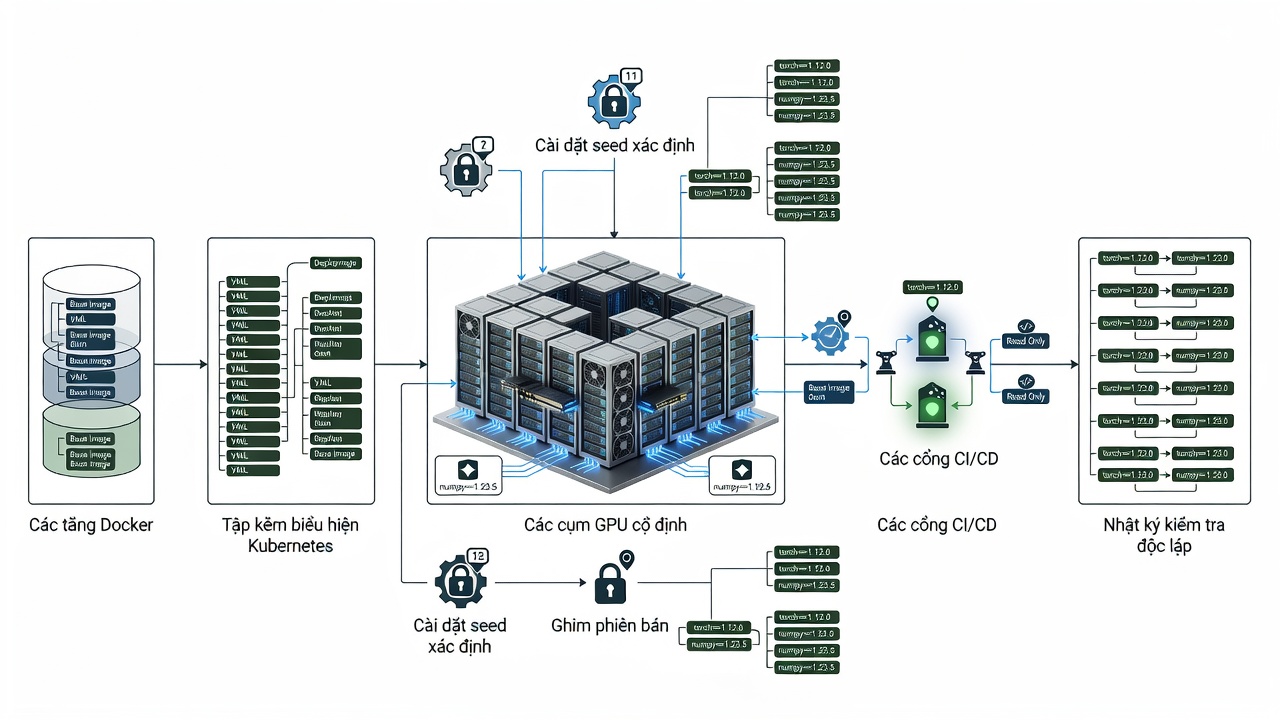
Nhóm thành công đóng gói toàn bộ pipeline bằng Docker đa tầng, tệp manifest Kubernetes được kiểm soát phiên bản và triển khai qua ArgoCD. Mỗi lần chạy đều khởi tạo cụm tạm thời với cấu hình GPU cố định (A100 80GB, driver 550). Nhóm thất bại sử dụng môi trường nhà phát triển chung, dẫn đến việc một lần nâng cấp driver NVIDIA ngầm đã thay đổi kết quả suy luận 7% mà không ai phát hiện trong ba tuần.
Seed cố định và trạng thái ngẫu nhiên
Mọi script của nhóm thành công đều đặt PYTHONHASHSEED=0, torch.manual_seed(42), numpy.random.seed(42), random.seed(42) và CUBLAS_WORKSPACE_CONFIG=:4096:8. Họ còn bật torch.use_deterministic_algorithms(True). Nhóm thất bại chỉ đặt seed ở một số tệp, bỏ qua seed worker của DataLoader. Khi mở rộng lên 8 GPU, thứ tự batch thay đổi khiến AUC trên tập kiểm tra giảm từ 0,912 xuống 0,871.
Khóa phiên bản thư viện
Nhóm thành công khóa chặt torch==2.3.0+cu124, torchvision==0.18.0+cu124, cuda==12.4, pytorch-lightning==2.3.3 và sử dụng uv để khóa toàn bộ cây phụ thuộc. Nhóm thất bại dùng torch>=2.2 và cập nhật tự động qua pip install -U. Sau khi PyTorch 2.4 ra mắt, một thay đổi nhỏ trong cuBLAS khiến kết quả lớp attention khác biệt đủ để mô hình chấm điểm tín dụng từ chối 14% hồ sơ mà trước đây chấp nhận.
Pipeline kiểm tra kết quả qua CI/CD
Nhóm thành công tích hợp kiểm tra khả năng sao chép vào GitHub Actions: mỗi lần đẩy mã nguồn kích hoạt công việc chạy trên self-hosted runner có GPU, so sánh đầu ra với tệp vàng đã ký hash SHA-256. Nếu sai lệch trên 0,5%, pipeline thất bại và chặn hợp nhất. Nhóm thất bại chỉ chạy kiểm tra đơn vị thông thường; kiểm tra khả năng sao chép bị vô hiệu hóa vì “chạy lâu”.
Cơ chế nhật ký kiểm toán độc lập
Nhóm thành công ghi nhật ký mọi siêu tham số, mã commit, digest ảnh Docker và chỉ số kết quả vào hệ thống nhật ký kiểm toán do bên thứ ba vận hành (không thể chỉnh sửa sau 1 giờ). Khi nhà đầu tư yêu cầu kiểm tra, họ xuất được chuỗi bằng chứng đầy đủ trong 4 giờ. Nhóm thất bại lưu nhật ký trong cùng kho lưu trữ, không có chữ ký số. Khi xảy ra tranh chấp với đối tác ngân hàng, họ không chứng minh được phiên bản mã nguồn nào đã tạo ra kết quả được báo cáo.
Khuyến nghị ngắn gọn
Đối với các nhóm AI fintech tại Việt Nam năm 2025, việc biến “sao chép độc lập kết quả” thành điều kiện bắt buộc trước khi đưa mô hình vào sản xuất không chỉ là thực hành kỹ thuật tốt mà còn là cơ chế tự bảo vệ trước rủi ro pháp lý và uy tín. Các yếu tố kỹ thuật nêu trên (container hóa, seed cố định, khóa phiên bản, cổng CI/CD và nhật ký kiểm toán độc lập) cần được coi là tiêu chuẩn tối thiểu thay vì tùy chọn.


